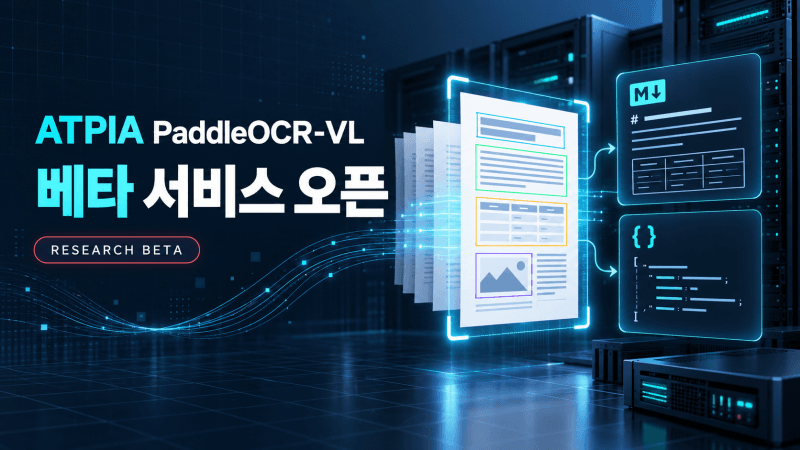
주식회사 ATPIA가 PaddleOCR-VL 1.6을 로컬 GPU 서버에 구축한 범용 문서인식 연구용 베타 서비스를 공개했다. 사용자는 이미지 또는 PDF를 올려 문서의 글자뿐 아니라 제목, 문단, 표, 수식, 이미지 등 레이아웃 구조를 분석하고 결과를 여러 형식으로 내려받을 수 있다. 서비스는 ATPIA가 독립적으로 구축·운영하며 Baidu 또는 PaddlePaddle의 공식 온라인 서비스는 아니다.
항목 | 확인 내용 |
|---|---|
공개 서비스 | paddleocr.atpia.com |
인식 엔진 | PaddleOCR-VL v1.6 전체 파이프라인 |
처리 장치 | NVIDIA RTX 3060 12GB GPU |
공개 재검증 | 이미지 3.104초 2페이지 PDF 6.839초 |
결과 형식 | Markdown JSON TXT ZIP |
운영 판정 | PARTIAL 공개 기능 검증 완료 초기 지연 보완 중 |
문자 추출을 넘어 문서 구조를 해석하는 서비스
기존 OCR은 종이 문서나 이미지 속 글자를 텍스트로 바꾸는 데 초점을 맞췄다. 실제 업무에서는 글자만 추출해서는 충분하지 않은 경우가 많다. 표의 행과 열, 제목과 본문, 수식과 그림, 여러 단으로 나뉜 읽기 순서가 함께 보존돼야 검색과 요약, 데이터 분석, 문서 자동화로 이어질 수 있기 때문이다.
ATPIA PaddleOCR 베타 서비스는 Transformers 기반 VLM만 따로 실행하는 방식이 아니라 PaddleOCR-VL 1.6 전체 문서 파싱 파이프라인을 사용한다. PP-DocLayoutV3가 페이지의 구성요소를 찾고 PaddleOCR-VL-1.6-0.9B 모델이 문자와 구조를 인식한 뒤, 읽기 순서에 따라 결과를 조합한다. 인식 결과는 화면에서 원문과 나란히 확인할 수 있고 Markdown, JSON, TXT, ZIP으로 저장할 수 있다.
업로드에서 결과 활용까지 이어지는 처리 과정
단계 | 처리 | 내용 |
|---|---|---|
1 | 파일 검사 | 확장자와 MIME 형식, 파일 내용과 문서 제한을 함께 확인한다. |
2 | 페이지 렌더링 | PDF를 페이지 단위로 변환하고 분석할 화면을 준비한다. |
3 | 레이아웃 분석 | PP-DocLayoutV3가 제목, 문단, 표, 수식, 이미지 영역을 구분한다. |
4 | 문자와 구조 인식 | PaddleOCR-VL 1.6 VLM이 각 영역의 문자와 구조를 해석한다. |
5 | 결과 조합 | 읽기 순서를 반영해 Markdown과 JSON, 일반 텍스트를 만든다. |
6 | 활용과 삭제 | 화면 검토, 복사, 다운로드 뒤 사용자가 즉시 자료를 삭제할 수 있다. |
작업은 비동기로 처리된다. 브라우저가 문서를 올리면 API가 파일을 검사하고 작업을 등록하며, 단일 GPU Worker가 대기열 순서에 따라 분석한다. 화면에는 대기 순번과 현재 단계, 페이지, 경과시간, heartbeat가 표시된다. 실제 페이지별 작업 상태를 보여 주며 근거 없는 진행률 숫자는 사용하지 않는다.
사용자가 확인하고 활용할 수 있는 결과
결과 화면은 문서 썸네일과 페이지 이동, 원본 확대와 축소, 문서 요소별 bounding box overlay를 제공한다. 사용자는 원문과 인식 결과를 비교한 뒤 내용을 복사하거나 필요한 형식으로 내려받을 수 있다. 표와 수식, 다단 편집, 세로쓰기 한자, 고문서풍 합성 자료, 기울어진 문서 등 여러 유형의 예제가 마련돼 서비스의 작동 방식을 살펴볼 수 있다.
지원 형식은 PDF, PNG, JPG, JPEG, BMP, TIFF이며 한 번에 문서 한 개를 처리한다. 이미지는 최대 10MiB, PDF는 최대 25MiB와 20페이지까지 받는다. 암호화 PDF와 다중 프레임 TIFF는 지원하지 않는다. 방향 감지와 왜곡 보정은 필요한 모델 캐시가 준비되지 않아 현재 비활성화돼 있다.
원문과 구조화된 인식 결과를 함께 확인하는 분석 작업공간 ATPIA 제공
로컬 GPU에서 확인한 실제 처리 성능
2026년 9월 12일 공개 환경 재검증에서 한국어 이미지 1페이지는 3.104초, PDF 2페이지는 6.839초에 성공 처리됐다. 두 작업 모두 준비된 동일 엔진을 재사용했고 재시도 없이 완료됐다. 결과에는 GPU 0번 장치, PaddleOCR-VL v1.6 파이프라인, PP-DocLayoutV3 레이아웃 모델 사용 기록이 남았다. 이 수치는 성공 시도의 추론과 결과 조합 시간이며 파일 업로드부터 사용자가 결과를 받기까지의 전체 대기시간과는 다르다.
ATPIA는 유리한 결과만 공개하지 않았다. 초기 공개 시험에서는 PDF 2페이지 작업이 369.08초 뒤 타임아웃됐고, 별도 이미지 작업은 한 차례 재시도한 뒤 완료됐다. 첫 브라우저 시험에서도 결과 대기가 420초를 넘었다. 모델이 준비된 뒤의 연속 작업은 빨랐지만 첫 추론 지연이 다시 나타날 가능성이 남아 있어 최종 운영 판정은 PASS가 아닌 PARTIAL로 유지했다.
현재 서비스는 GPU 동시 처리 1건, 모델 인스턴스 1개, 최대 대기열 5건으로 제한한다. 모델 초기화와 페이지 단위 soft timeout은 각각 180초, PDF 또는 작업 전체 hard timeout은 900초다. 타임아웃 재시도는 최대 한 번이며 메모리 부족은 반복 재시도하지 않는다. 연구용 베타 단계에서 안정성과 GPU 자원을 함께 관리하기 위한 보수적인 운영 기준이다.
파일 검사와 24시간 이내 삭제 정책
업로드 단계에서는 확장자만 확인하지 않는다. MIME 형식, magic byte와 실제 parser 결과를 함께 검사해 HTML, SVG, Office 문서, 실행파일 등 허용하지 않은 형식을 차단한다. 내부 저장경로에는 사용자가 올린 파일명을 쓰지 않고 UUID를 사용하며, runtime 디렉터리와 파일 권한도 제한한다.
원본 문서와 결과는 문서 인식에만 사용하며 학습 데이터로 쓰지 않는다. 생성된 자료의 만료 시각은 23시간 50분 뒤로 설정했고 Worker와 독립 정리 timer가 24시간 상한 전에 삭제를 수행한다. 사용자가 삭제 버튼을 누르면 접근권한을 즉시 폐기하고 처리 종료를 확인한 뒤 원본과 결과를 지운다. 만료 자료는 물리 정리가 끝나기 전이라도 API 접근이 차단된다.
공개 접속 검증에서는 다른 세션의 결과 요청과 삭제 뒤 페이지 요청이 모두 404로 차단됐다. cookie에는 HttpOnly, Secure, SameSite Strict 속성을 적용했고 Origin 검사, CSP nonce, HTML 정화, 단일 origin CORS 정책을 사용한다. 다만 24시간을 실제로 기다리는 장기 경과 시험과 호스트 재부팅 뒤 복구 검증은 아직 실시하지 않았다.
독립 서비스 운영과 기존 ATPIA 환경 보존
웹 화면과 API는 외부에 직접 포트를 열지 않고 Apache HTTPS reverse proxy 뒤에서 동작한다. API, Web, GPU Worker와 자동 정리 작업은 전용 비root 계정으로 운영되며 systemd 보호 옵션을 적용했다. 기존 qwen-web, Qwen3-VL과 ATPIA 홈페이지의 운영 상태를 유지했고 중지돼 있던 Qwen3-TTS도 그대로 보존했다. 기존 UDR의 기본 Provider를 교체하거나 데이터베이스를 변경하지 않았다.
관리 운영을 위한 별도 대시보드도 개발됐다. 방문과 작업 현황, 성공과 실패, 대기시간과 처리시간, 파일 형식과 페이지, 모델, 오류, 보관 상태를 검색·확인하도록 설계했다. 관리자 인증은 환경파일의 자격정보만 사용하고 세션과 접근 제한, CSRF 방어, 감사기록을 분리했다. 다만 첨부된 관리자 구축보고서 기준으로 운영 데이터베이스의 실제 백업과 복원, migration, 공개 관리자 및 GPU 연계 시험은 남아 있어 검증 완료 뒤 운영 반영할 예정이다.
베타 서비스 이용 방법
서비스는 연구용 베타로 운영된다. 이용을 원하는 개인과 기관은 contact@atpia.com으로 사용 목적과 대상 문서 유형을 문의하면 된다. 안내받은 체험 비밀번호를 문서 분석 시작 단계에서 입력해야 실제 분석이 진행된다. 민감한 개인정보, 비밀번호, 주민등록번호, 금융정보, 공개가 제한된 문서는 올리지 않아야 하며 중요한 결과는 반드시 원문과 대조해야 한다.
서비스 바로가기 ATPIA PaddleOCR 베타 서비스 이용 문의 contact@atpia.com
ATPIA 범용 문서인식 기술을 넓히는 실증 무대
이번 공개는 하나의 OCR 화면을 추가한 데 그치지 않는다. ATPIA가 추진하는 Universal Document Recognition 연구에서 서로 다른 인식 엔진을 실제 환경에 설치하고, 같은 기준으로 구조와 성능, 보안과 운영성을 검증하기 위한 실증 서비스다. 공개된 웹 화면과 API, GPU Worker, 결과 내보내기, 삭제 정책을 하나의 운영 흐름으로 연결했다는 점에 의미가 있다.
후속 개발의 우선순위는 초기 VLM 지연 원인 분석과 cold start 반복 시험이다. 이미지와 다중 페이지 PDF의 실패율, 지연 분포, 재시도 빈도를 축적하고 24시간 경과와 서비스 재기동, 승인된 점검 시간의 호스트 재부팅까지 검증할 계획이다. 한자와 희귀문자는 표준 정답셋으로 CER과 WER, 구조 정확도를 측정하고 오인식 유형을 분류해야 한다.
UDR Provider 연동과 기존 PP-OCRv6, Qwen3-VL과의 비교는 안정성 검증 뒤 별도 결과 경로에서 진행한다. 실제 고문서 품질은 별도 benchmark로 확인해야 하며, 현재 제공되는 고문서풍 예제는 서비스 작동을 보여 주는 합성 자료일 뿐 실제 사료 판독 성능을 입증하지 않는다.
연구용 베타에서 운영 제품으로
ATPIA는 문서를 검색 가능한 데이터로 바꾸고, 그 결과를 요약과 질의응답, 행정·법률 문서 작성, 기업 데이터 분석으로 연결하는 로컬 AI 기술을 개발하고 있다. PaddleOCR 베타 서비스는 그 과정에서 문서 구조 인식과 GPU 운영, 보안과 보관 정책을 공개 환경에서 점검하는 단계다.
현재 결과는 공개 기능이 작동한다는 사실과 운영 안정성이 완성됐다는 판단을 구분한다. ATPIA는 성공 수치와 실패 기록을 함께 남기고, 재현 가능한 검증을 거쳐 서비스 범위를 넓힐 방침이다. 문서 유형별 품질 데이터와 장기 운영 근거가 쌓이면 중소기업과 기관이 보유한 문서를 내부 환경에서 활용하는 ATPIA AI Box와 범용 문서인식 시스템의 핵심 구성요소로 발전시킬 계획이다.
기사 작성 기준
이 기사는 2026년 9월 12일자 ATPIA PaddleOCR-VL 최종개발보고서와 관리자 페이지 구축 결과를 토대로 작성했다. 운영 상태와 성능 수치는 해당 검증 시점의 기록이다. PaddleOCR 코드와 공식 모델은 Apache 2.0 라이선스로 식별됐으며, ATPIA 서비스는 공식 온라인 서비스와 별개의 독립 Research Beta다.
공식 프로젝트 PaddlePaddle PaddleOCR 모델 카드 PaddleOCR-VL-1.6